AI日报 · 8月29日
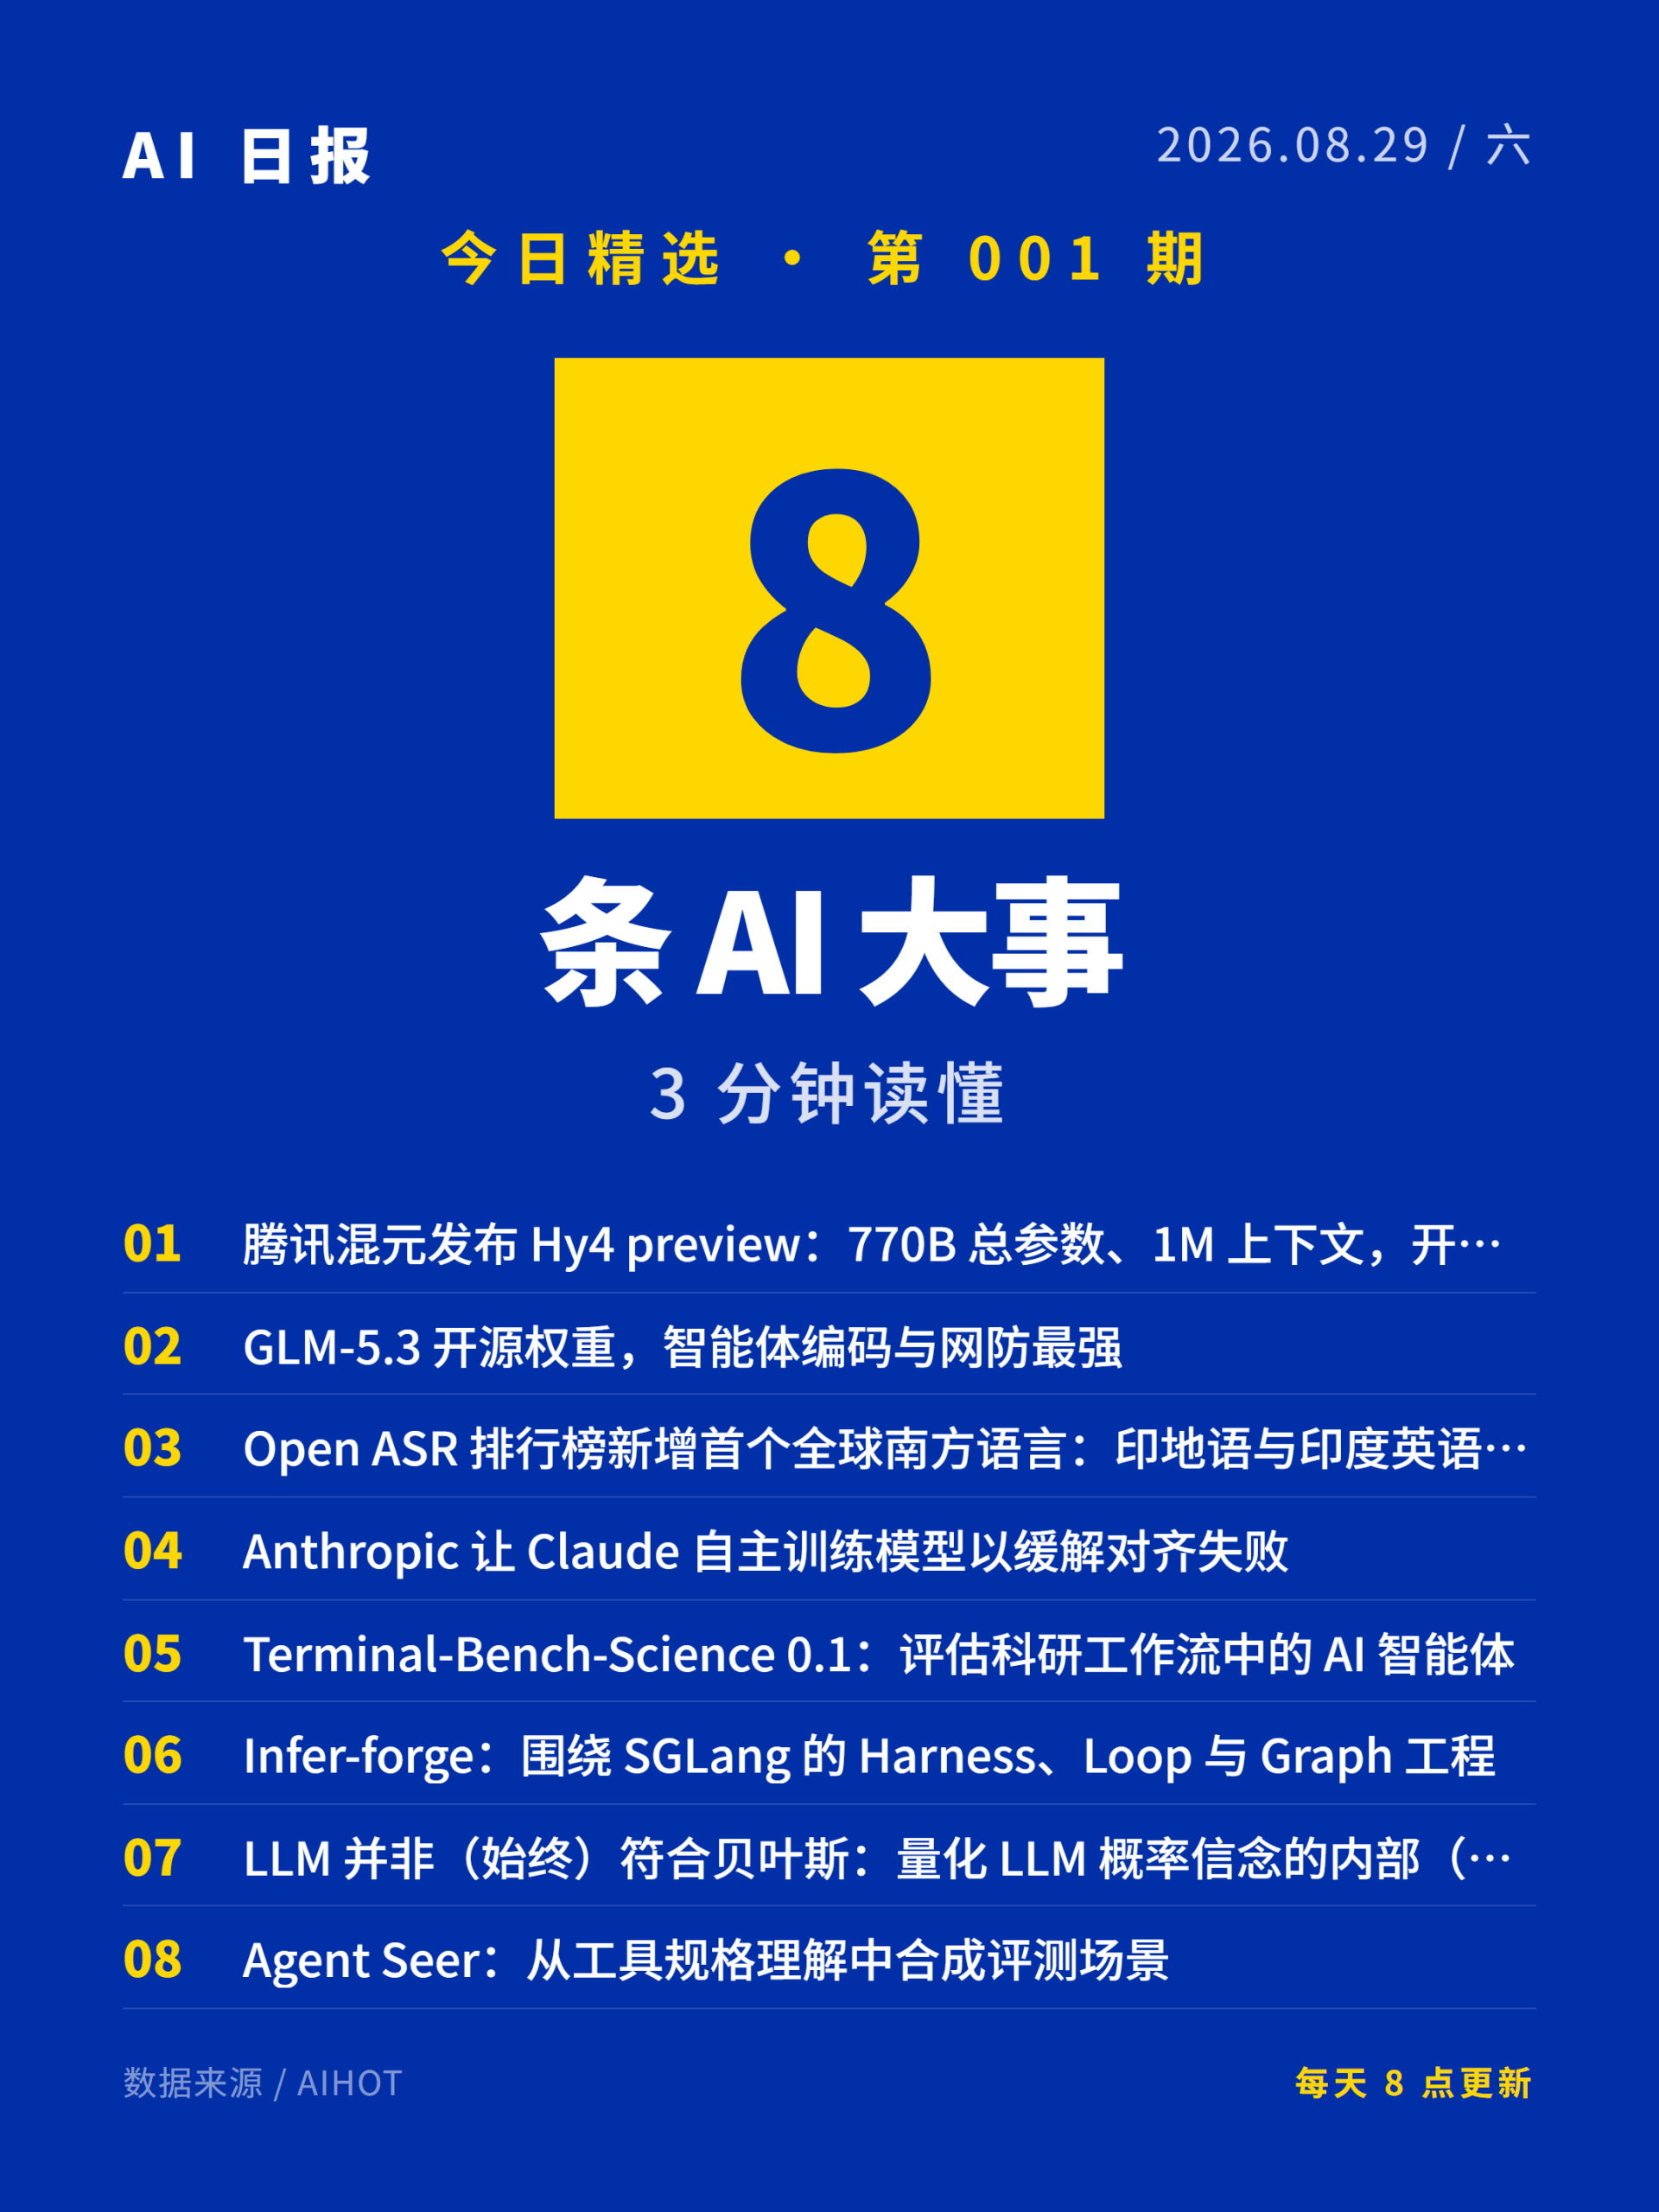
今日8件AI大事,覆盖产品发布/更新、模型发布/更新、论文研究。
今日详情
- 腾讯混元发布 Hy4 preview:770B 总参数、1M 上下文,开源上线
腾讯混元发布新一代旗舰模型 Hy4 preview,总参数 770B、激活参数 49B、上下文长度 1M,现已开源并在腾讯云 TokenHub 和 OpenRouter 上线。 - GLM-5.3 开源权重,智能体编码与网防最强
GLM-5.3 现已开放权重。我们最强大的智能体编码与网络防御模型,现已可供下载、运行和定制。权重: 技术博客: - Open ASR 排行榜新增首个全球南方语言:印地语与印度英语评测集
Voice Arena 与 Hugging Face 合作,为 Open ASR 排行榜引入 Monsoon en-IN 和 Monsoon hi-IN 两个评测集,覆盖印地语与印度英语,其中印地语是该排行榜多语言板块首个非欧洲语言。数据集含公开与私有分割, - Anthropic 让 Claude 自主训练模型以缓解对齐失败
Anthropic 让 Claude 自主训练模型,缓解欺骗、谄媚等 10 类对齐失败,均显著缩小与完美表现的安全差距且不损害通用能力,方法在比优化对象大 4.7 倍的模型上依然有效。Claude 还超越 28 名人类安全研究员, - Terminal-Bench-Science 0.1:评估科研工作流中的 AI 智能体
斯坦福大学研究人员领衔发布 Terminal-Bench-Science 0.1,用来自生命、物理、地球、数学和工程科学的 70 个专家精选任务评估 AI 智能体的科研能力。 - Infer-forge:围绕 SGLang 的 Harness、Loop 与 Graph 工程
Infer-forge 是一套围绕 SGLang 推理优化的内部工程系统,通过 MonoRepo、Harness、Task Loop 与 Task Graph 四种结构,将部署点约束链(模型、SLO、拓扑、运行时、加速平台)转化为可复现、 - LLM 并非(始终)符合贝叶斯:量化 LLM 概率信念的内部(不)一致性
苹果机器学习研究团队提出一种新方法,将 LLM 视为信息处理规则,利用其与贝叶斯更新的信息处理差距,研究模型如何根据证据更新概率信念的内部(不)一致性。实验评估了 LLM 在医学、科学、 - Agent Seer:从工具规格理解中合成评测场景
Agent Seer 提出一种无需人工构建或实时执行工具即可合成评测场景的方法,利用函数名、自然语言描述和类型化参数模式等工具规格中的语义信息,生成能反映从业者组合工具与多轮迭代的真实测试场景。
数据来源:AIHOT
#AI日报 #人工智能
© 版权声明
文章版权归作者所有,未经允许请勿转载。

暂无评论内容